réponses sourcées/instance dédiée/hébergé en France
Vos réponses sont déjà écrites quelque part.Le problème, c’est de les retrouver.
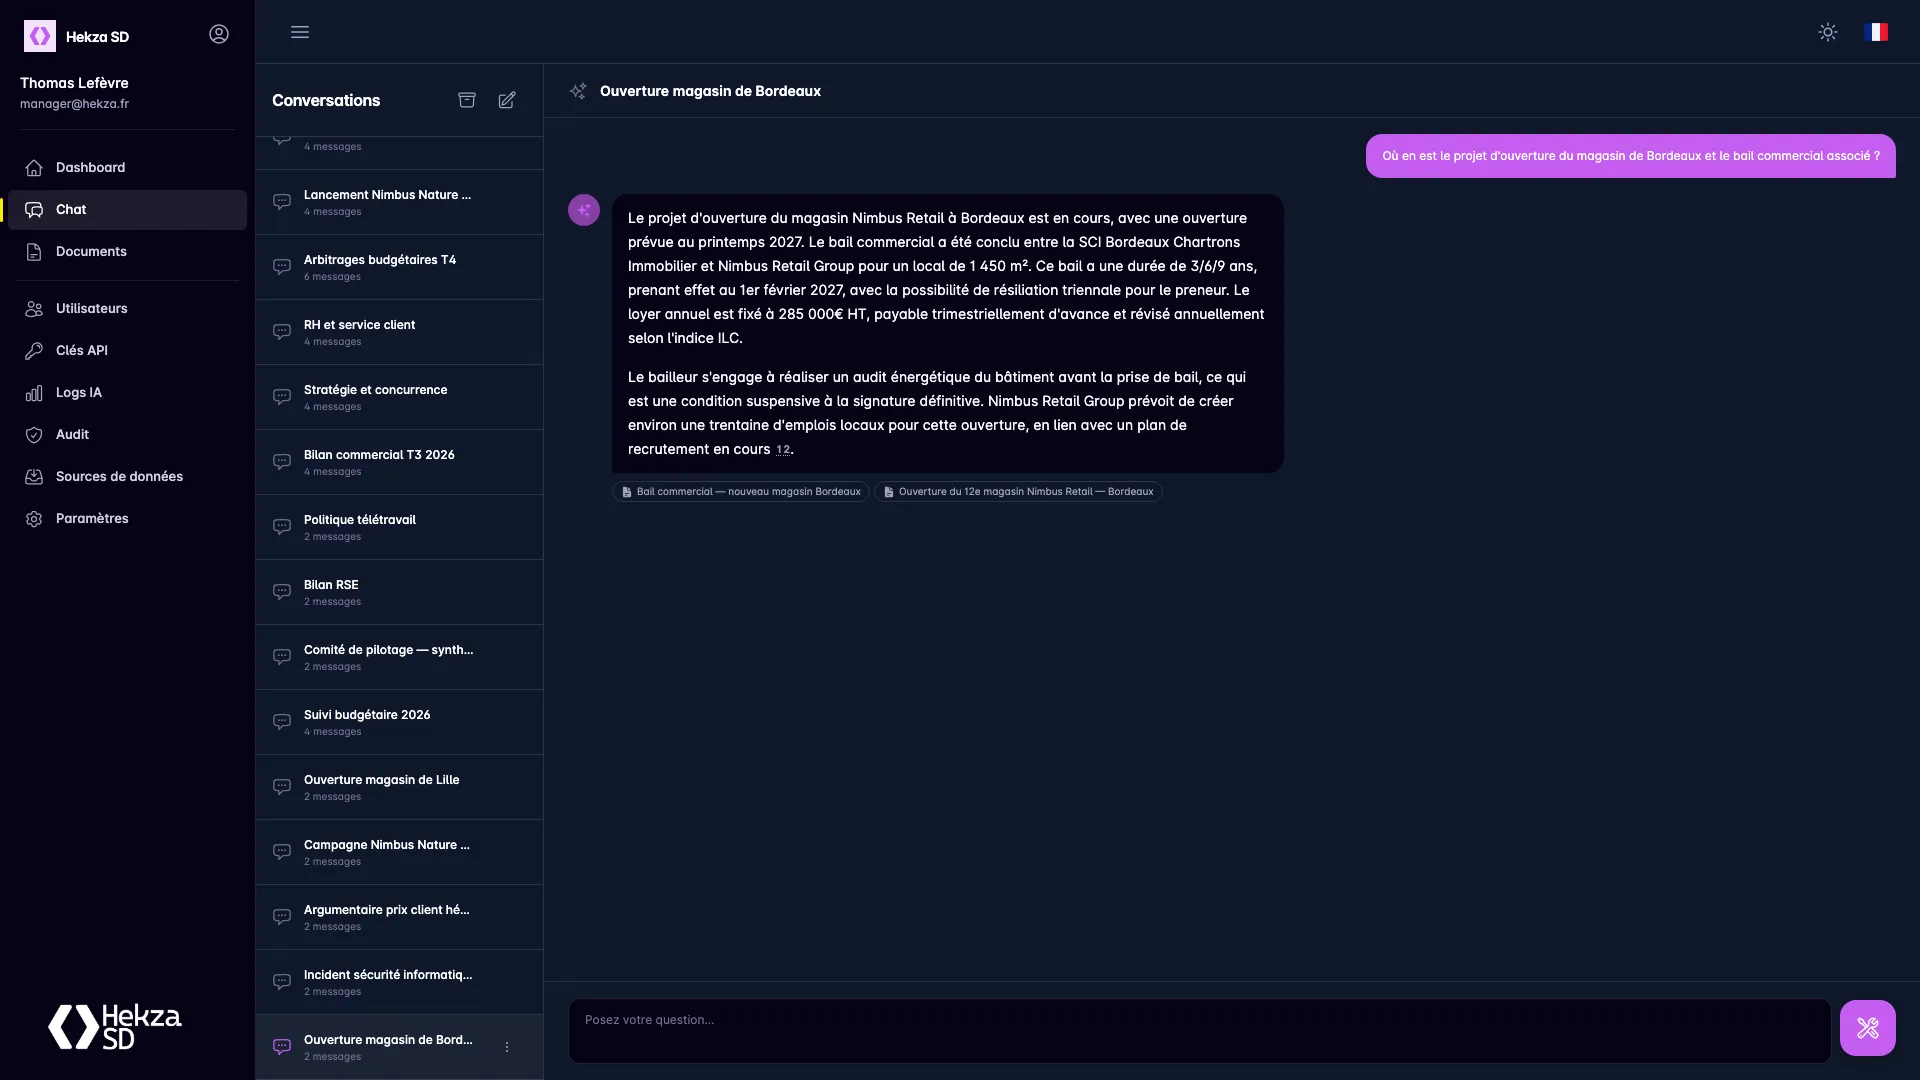
AI Knowledge Hub indexe vos procédures, contrats, e-mails et documents, et permet à vos équipes de les interroger comme on interroge un collègue expérimenté — chaque réponse citant le document, la page et le passage exact dont elle provient.
Ce que la plateforme sait indexer
- DOCX
- TXT
- Markdown
- HTML
- CSV
- JSON
- XML
- Boîtes e-mail (IMAP)
- Flux RSS / Atom
- OneDrive
- SharePoint
- API d’ingestion
Le problème
L'information existe. Personne ne la retrouve.
Ce n'est pas un problème d'intelligence artificielle, c'est un problème d'accès. La bonne réponse est écrite quelque part — dans un PDF, un e-mail, une procédure mise à jour l'an dernier.
- 20 min
perdues par recherche
Un collaborateur qui cherche une information déjà rédigée, plusieurs fois par jour, sur des dizaines de documents éparpillés.
- v3 · v4
la mauvaise version appliquée
La procédure appliquée n'est presque jamais la dernière. Le coût de l'erreur, lui, est immédiat.
- 3×/jour
la même question posée
Chaque arrivée dans l'équipe re-paie le coût de la recherche d'information, et occupe quelqu'un de plus expérimenté.
La preuve
Chaque réponse cite sa source. Sans source, pas de réponse.
C'est la différence structurelle avec un assistant grand public. Le système ne répond que sur la base de passages retrouvés dans vos documents, il affiche lesquels, et quand il ne trouve rien, il le dit.
- 01
Document, page, passage
Chaque réponse porte ses puces de citation, cliquables, qui ouvrent le document exact dont provient l'information.
- 02
Re-ranking local anti-contamination
Un cross-encoder exécuté sur l'instance re-classe les passages candidats avant la réponse, pour ne pas mélanger deux dossiers qui se ressemblent.
- 03
Le refus de répondre
Question hors périmètre : l'assistant répond qu'il n'a pas l'information, au lieu d'improviser une réponse plausible.
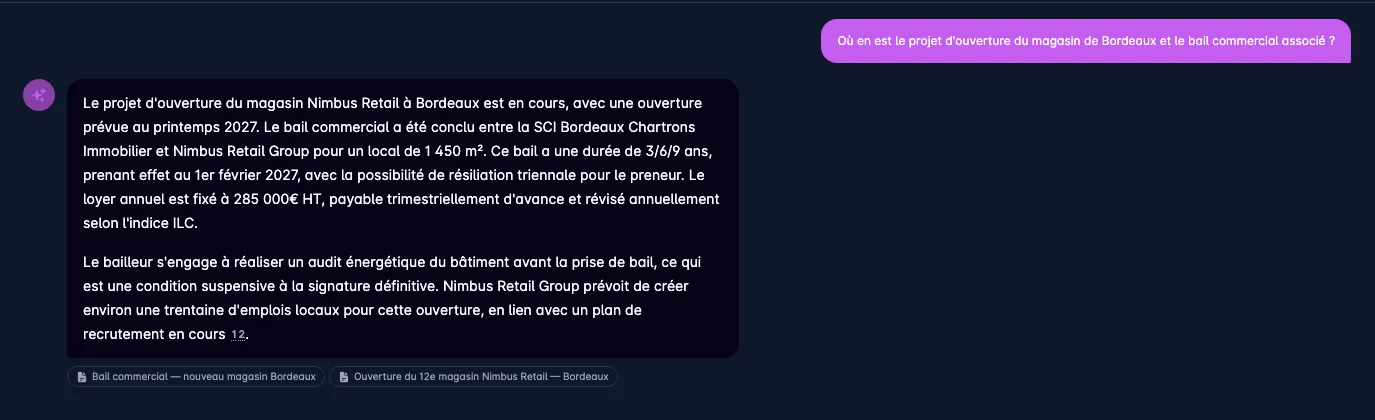
La question dont la réponse n'existe pas
Le moment le plus convaincant d'une démonstration : on pose volontairement une question hors du corpus.
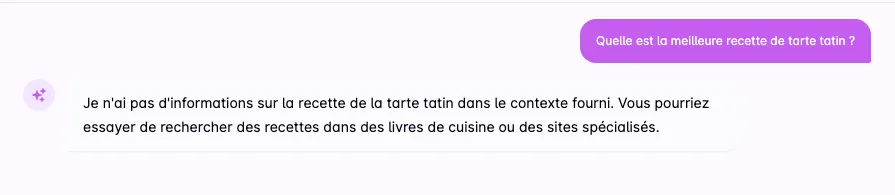
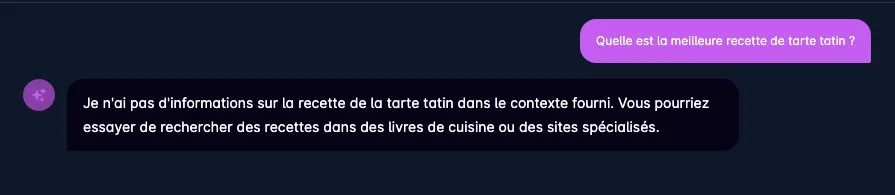
Les deux autres questions
Une instance à vous. Un budget que vous fixez.
- Une instance dédiée, hébergée en France
- Base de données, index vectoriel et stockage dédiés à votre organisation. Aucune mutualisation, et rien à administrer chez vous : nous exploitons l'instance.Le détail technique
- Un plafond de dépense dans le logiciel
- Le budget mensuel est un réglage, pas une promesse : au niveau de l'organisation, et par utilisateur si vous le souhaitez. Atteint, il bloque.Voir le suivi des coûts
Ce que vous avez, et ce qui se construit
Le jour de la mise en service, vous avez un chat sur vos documents.
Nous préférons le dire avant la signature plutôt qu'après : la plateforme livre une base de connaissances interrogeable et son administration. Les automatisations qui branchent cette base sur vos autres outils sont un travail d'intégration — nous le chiffrons et nous le réalisons, mais ce n'est pas fourni clé en main.
Livré avec la plateforme
- Le chat sourcé sur vos documents, avec historique de conversation
- La recherche sémantique et le re-classement des passages
- L’import de fichiers et les connecteurs e-mail, RSS, OneDrive/SharePoint
- La console d’administration : utilisateurs, sources, clés d’API, identité visuelle
- Le suivi des coûts, les plafonds de budget, le journal d’audit
- L’API publique et les webhooks, prêts à être appelés
Construit sur devis, par nous
- Le brouillon de réponse préparé automatiquement dans votre outil de ticketing
- L’assistant de support branché sur votre CRM ou votre messagerie
- Les automatisations n8n, Make ou équivalent autour de la base
- Un connecteur sur mesure vers votre GED, votre ERP ou un outil métier
- L’intégration à votre intranet ou à une application interne existante
Ces automatisations s'appuient sur l'API et les webhooks déjà livrés — la brique technique existe. Ce qui se chiffre, c'est le travail de branchement à vos outils, à vos règles et à vos procédures.
Cas d’usage
Ce que vos équipes en font vraiment.
Trois usages disponibles dès la mise en service, et trois autres que nous construisons autour de la base quand le besoin le justifie.
- Inclus
Documentation interne
« Quelle est la procédure pour… ? » — réponse sourcée, tirée de la dernière version en base.
- Inclus
Onboarding et formation
Un nouvel arrivant pose ses questions à la base plutôt qu'à un collègue déjà occupé, et vérifie d'où vient la réponse.
- Inclus
Aide à la décision
Croiser plusieurs documents sans confondre deux dossiers, grâce au re-classement des passages.
Sur devisBrouillons de réponse · Support outillé · Intégration à vos outilsVoir les cas d’usage en détail
Comparaison
Chez eux, chaque utilisateur coûte plus cher.
Coût mensuel indicatif pour une PME de 50 personnes, sur la base des tarifs publics de septembre 2026.
| Solution | Modèle | Coût mensuel · 50 utilisateurs |
|---|---|---|
| Glean | SaaS, facturation par utilisateur | ≈ 2 300 € |
| Dust | SaaS, facturation par utilisateur | ≈ 1 450 € |
| ChatGPT Entreprise | SaaS, facturation par utilisateur | ≈ 1 250 € |
| AI Knowledge Hub | Forfait au volume indexé, utilisateurs illimités | 290 à 790 € |
Chez nous le prix suit le volume indexé, pas les effectifs : chaque nouvel utilisateur fait donc baisser le coût par tête, et la consommation IA est comprise dans le montant. Les tarifs concurrents sont indicatifs, relevés publiquement, et s’entendent hors consommation.
Tarifs
Une mise en service, puis un abonnement au volume.
Prix HT, engagement 12 mois. Aucune facturation par utilisateur : chaque nouvel arrivant fait baisser le coût par tête au lieu de l’augmenter.
Mise en service
1 900 €une seule fois
Abonnement mensuel
290 €jusqu’à 2 000 documents indexés · ou ~10 Go
Par où commencer
Le diagnostic IA documentaire
1 500 € HT3 jours · livrable en une semaine
Nous ne faisons pas de démonstration gratuite sur vos documents : nous faisons un diagnostic payant, intégralement déduit du projet si vous signez sous 30 jours.
Réserver 20 minutes- La cartographie de vos sources de connaissances : où vit l’information, qui la maintient, ce qui est périmé.
- Trois cas d’usage chiffrés en heures et en euros, classés par rapport effort/gain.
- Une maquette réelle sur vos propres documents : 20 à 50 de vos fichiers indexés, 10 questions de vos équipes, les réponses obtenues et leurs sources.
- Une note d’architecture et de conformité : où vivent les données, ce qui part chez le fournisseur de modèle, ce qui n’en part pas.
Ce type de diagnostic est éligible à plusieurs dispositifs publics d’accompagnement à la transformation numérique et à l’IA — nous vous indiquons lesquels s’appliquent à votre cas.
Questions fréquentes
Les questions que l’on nous pose vraiment.
En quoi est-ce différent de ChatGPT ou de Copilot ?
ChatGPT connaît le monde, pas votre entreprise : il ne sait pas ce que dit votre procédure de garantie dans sa version d'avril, et quand il ne sait pas, il propose une réponse plausible. Copilot lit ce à quoi l'utilisateur a accès dans Microsoft 365, sans citation vérifiable au passage près, et sans rien savoir de ce qui vit ailleurs. Ici, chaque réponse indique le document, la page et le score de pertinence — et l'absence de source produit une absence de réponse.
Concrètement, qu’est-ce qu’on a le premier jour ?
Une base de connaissances interrogeable : vos documents indexés, un chat qui répond en citant ses sources, la recherche, les connecteurs vers vos fichiers, vos e-mails et votre SharePoint, et la console d'administration qui va avec (utilisateurs, budget, clés d'API, audit). Ce que vous n'avez pas ce jour-là, ce sont les automatisations vers vos autres outils : brouillons de réponse dans votre ticketing, assistant branché sur votre CRM, workflows n8n. L'API et les webhooks existent pour les construire, mais ce branchement est un projet d'intégration que nous chiffrons et réalisons à part.
Qui administre l’outil ?
Vous avez deux rôles : le manager, qui invite les utilisateurs, gère les sources de données, les clés d'API et l'identité visuelle ; et l'utilisateur, qui pose ses questions et consulte les documents. Le rôle d'administration technique — réglages du modèle, budgets, paramètres d'indexation, webhooks — reste chez nous : c'est l'exploitation de l'instance, et elle fait partie de l'abonnement. Vous n'avez donc besoin d'aucune compétence informatique en interne.
Où sont hébergées nos données ?
Sur une instance dédiée que nous exploitons en France : base de données dédiée, index vectoriel dédié, aucune mutualisation avec un autre client. Le seul flux sortant est l'appel au modèle de langage, limité au passage nécessaire à la réponse, et documenté dans la note d'architecture que nous remettons avant la signature.
Et si l’IA invente une réponse ?
La réponse n'est pas « notre IA ne se trompe jamais », elle est structurelle : le système ne répond que sur la base de passages retrouvés dans vos documents, il affiche lesquels avec leur score, un re-classement local écarte les passages qui ressemblent sans correspondre, et sans source retrouvée il n'y a pas de réponse. C'est démontrable en direct, et c'est ce que nous montrons en premier.
Combien coûte réellement la consommation d’IA ?
Rien de plus que l'abonnement : un montant fixe de 60 € par mois y est compris, et c'est exactement le plafond réglé dans l'instance avant la mise en service. Nous ne refacturons jamais au réel, donc aucune facture surprise — en contrepartie, consommer moins que le montant compris ne le fait pas baisser. Pour situer les ordres de grandeur, une PME de 50 personnes qui utilise réellement l'outil consomme de 30 à 90 € de modèle par mois, l'indexation initiale coûtant une dizaine d'euros une fois pour toutes. Si votre usage réclame davantage, on relève le plafond et on en parle avant.
Quels formats et quelles sources sont pris en charge ?
À l'import : PDF, DOCX, TXT, Markdown, HTML, CSV, JSON, XML, plus le texte libre et les URL publiques. En synchronisation continue : boîtes e-mail IMAP, flux RSS/Atom, OneDrive et SharePoint. Les classeurs Excel et les présentations PowerPoint ne sont pas encore pris en charge à l'ingestion.
Que récupérons-nous si nous arrêtons ?
Vos documents, votre corpus et votre historique de conversations, exportables. Vous restez propriétaire de vos données et de votre corpus ; nous restons propriétaires du logiciel. C'est écrit dans le contrat, avec les délais et le format de restitution.
Vingt minutes suffisent pour savoir si c’est pour vous.
Nous vous montrons l'outil sur un corpus de démonstration proche de votre métier : une question réelle, sa réponse sourcée, une question sans réponse, et le tableau de bord des coûts. Sans engagement.